temavorobey
6 ноября 2026 года OpenAI опубликовала тест BioBasicsBench: 100 задач из настоящей лаборатории, где модель разбирает сырые фото, снимки с микроскопа, таблицы и рукописные заметки и должна не делать выводов, которых данные не подтверждают. Лучший результат у GPT-6 Astra: 66,7% от возможных баллов. GPT-6.1 Sol рядом с 62%, а прошлое поколение GPT-5.6 Sol набрало 43,8%. Подробности и примеры - в блоге OpenAI.
ChatGPT Plus и Pro на ваш аккаунтОплата картой РФ или СБП КупитьПочему это не только про биологов
Обычные тесты берут аккуратные графики из научных статей. Здесь данные такие, какими их видит человек за рабочим столом: фото с телефона, мутные снимки, выгрузки из Excel и CSV, фото экранов приборов, записи от руки, короткие видео. Задачи собрали учёные биотех-компании Ligo на данных своих экспериментов, каждую проверили три раза.
Ровно с таким материалом люди приходят в ChatGPT: скан договора, фото счётчика, таблица с отчётом. Поэтому тест хорошо показывает, какая модель внимательнее к мелочам на картинке.
Astra против Sol
| Модель | Баллы | Длина ответа, токенов |
|---|---|---|
| GPT-6 Astra | 66,7% | 4 704 |
| GPT-6.1 Sol | 62,0% | 5 238 |
| GPT-5.6 Sol | 43,8% | 9 099 |
| GPT-6 Luna | 38,3% | 13 120 |
Замеры OpenAI в режиме, где модели дают дольше думать над задачей. Токен - кусочек слова, так что последняя колонка показывает, сколько модель «написала» на одну задачу. Astra набрала больше и обошлась самым коротким рассуждением. Но разрыв с Sol невелик: по данным OpenAI, их диапазоны погрешности пересекаются (60,3-73,1% против 55,6-68,4%).
Что Astra замечает
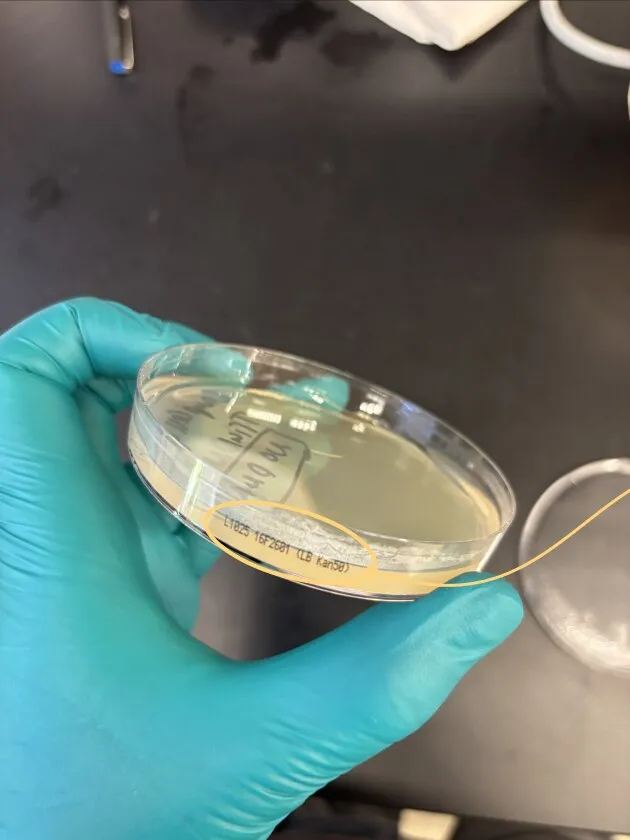
В одной задаче прошлая модель сделала вывод по пустой чашке с бактериями. Astra прочитала мелкую подпись на краю: «LB Kan50», то есть чашка с другим антибиотиком, и проверкой она служить не может.
В другой задаче клетки на видео с микроскопа то пропадали, то появлялись. Старая модель искала биологическую причину, Astra поняла, что микроскоп просто снимал на разной глубине.
Где подвох
OpenAI прямо пишет: высокие баллы пока не значат, что модели можно доверять решения. Слабые места Astra из того же отчёта:
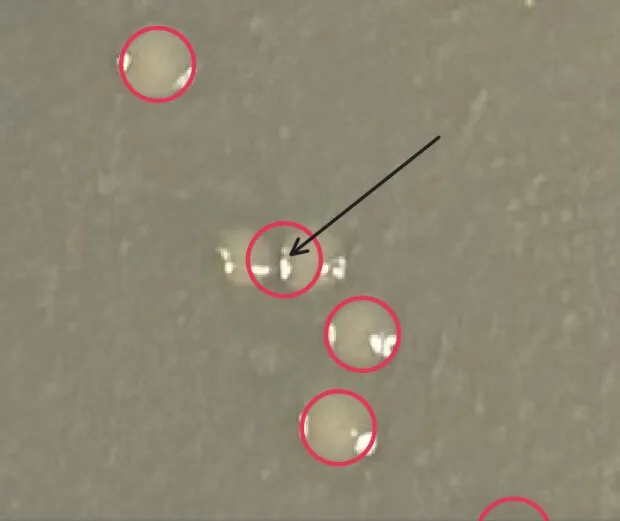
- Счёт предметов на фото. Колоний на чашке она насчитала примерно на 12% больше: сливала соседние, пропускала видимые и отмечала пустое место.
- Привычка сильнее данных. На снимке с пробами выбрала не те образцы, потому что понадеялась на «обычно так».
- Неудобные наблюдения. Заметила то, что противоречит её версии, но в итоговый ответ не взяла.
Практический вывод: если просите посчитать что-то на фото или свести цифры со скана, перепроверяйте итог.
Что это значит для нас
Для разбора фото, сканов и таблиц сейчас сильнее Astra, Sol отстаёт ненамного. Кому и где доступна каждая модель, мы разбирали в новостях про выход Astra и про GPT-6.1 Sol. Оплатить ChatGPT российской картой напрямую не выйдет, платёж отклоняется. Подписка ChatGPT Plus и Pro есть в нашем каталоге, оплата картой РФ или СБП.